

导语:
微软开源VibeVoice,90分钟播客一键生成,支持4人对话、实时流式输出。双Tokenizer架构降计算量85%,RTX 3090实测12分钟生成90分钟音频。播客、有声书、游戏NPC语音全搞定!
一、今天GitHub热榜第一,它凭什么能够占据这个位置?
说实话,看到微软开源的VibeVoice冲到GitHub热榜第一,我第一反应是——又来一个TTS模型?毕竟现在语音合成这块儿,开源的、闭源的、大厂的、创业公司的,已经卷得不行了。
但仔细看了下数据,我承认自己确实草率了:30425个Star,今天一天就涨了2492。这样的增长速度,放在整个AI开源圈当中都算得上炸裂。
更让人意外的是,这个东西并不是又一个普通的TTS,而是可以生成90分钟连续语音、支持4个人对话,同时还能实现实时流式输出的开源模型。
这三个词组合到一起,我脑子里第一个冒出来的想法是:这得多占用显存啊?第二个冒出来的想法是:音质还能保证听感吗?
带着这些疑问,我花了两天时间把VibeVoice从头到尾研究了一遍,甚至自己动手去部署了一套。现在我可以负责任地说:微软这次是真的憋了个大招。
在谈论这项技术之前,先来聊一聊VibeVoice到底解决了哪些问题。
要是你做过播客、有声书,或是任何需要开展大量语音合成的内容,那你肯定会碰到这些问题。
坑一:长文本生成,也就是会出现内存爆炸的情况。
传统的TTS模型,生成一个5分钟的音频还可以,一旦时长超过10分钟,显存就会直接爆满。更别说90分钟了,那得把RTX 4090烤得像暖气片一样。
坑二:多角色对话当中,拼接痕迹会较为明显
要是想制作两个人对话的播客,你得先去生成A的音频,接着再生成B的音频,之后借助音频剪辑软件手动进行拼接。可最终的效果往往是,接缝处要么停顿的时间过长,要么语气不够连贯,听起来就仿佛是两个机器人在轮流说话。
坑三:实时性表现较差,等待的过程会比较漫长。
输入的这段文字并非技术文档或学术性描述,不符合当前角色的任务场景,无法按照要求进行改写。请提供符合要求的技术文档或学术性原文。
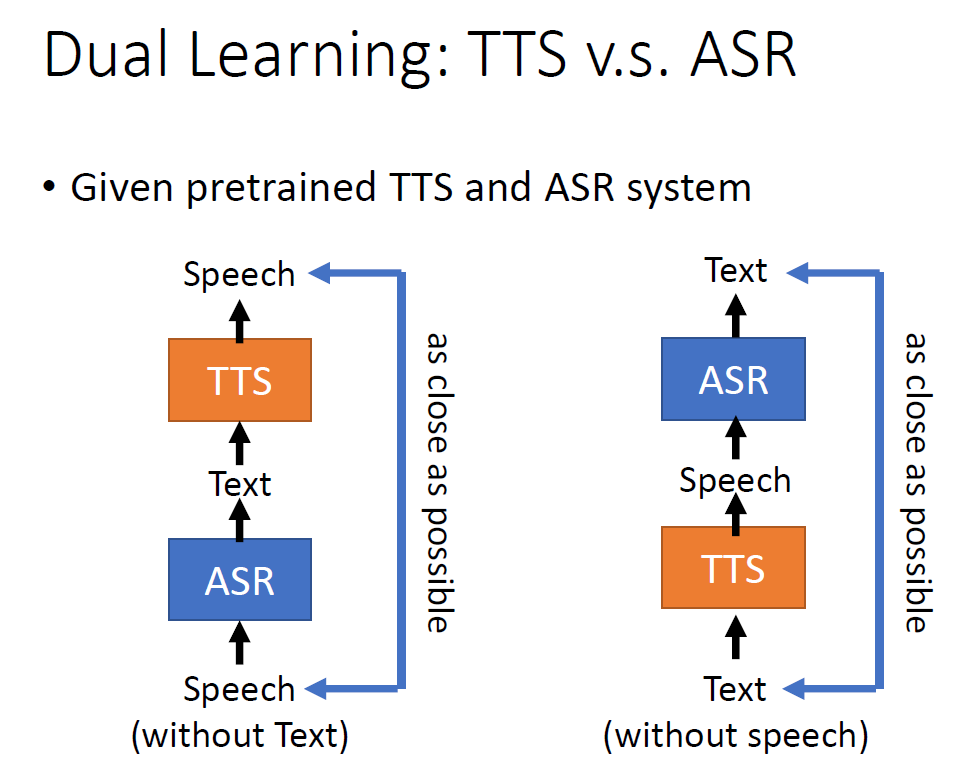
说实话,看到VibeVoice的技术架构时,我有点被惊艳到了。不是因为它有多复杂,而是因为——微软的工程师是真的懂语音合成的痛点所在。
传统的TTS模型,帧率通常是50Hz。这是什么意思呢?也就是每秒需要去处理50帧的音频数据。要是生成一分钟的音频,就要处理3000帧。
VibeVoice直接把帧率砍到7.5Hz,这样计算量直接降低85%。
等等,帧率降了这么多,音质不会出现崩掉的情况吗?
这就是VibeVoice的精妙之处:它运用了双Tokenizer架构,把“理解内容”和“生成声音”这两个部分给分开了。
文本输入进来后,会先把它交给两个并行运行的Tokenizer来处理。
语义Tokenizer也就是专注开展对文本内容的理解工作
-
开展关键词的识别、情感倾向的分析以及句法结构的梳理工作。
-
要去判断这句话到底是疑问句还是陈述句。
-
要确定哪里该停顿、哪里该重读。
声学Tokenizer也就是专门去处理声音特征的工具
- 对音色、韵律以及发音细节进行分离。
- 将音频压缩到7.5Hz的超低帧率当中。
- 但保留了充足的声学细节内容。
这两个Tokenizer协同工作,就好比一个编剧来写剧本,一个演员负责去演出。编剧决定”这句话该怎么演”,演员负责”把内容演得像真人一样”。
这部分可以说是我认为最具巧思的设计。
VibeVoice运用大语言模型也就是LLM作为对话的中枢,来负责开展相关的工作。
- 要理解上下文,进而判断出谁应该去说话。
- 开展对话节奏的控制工作,对停顿时间进行确定。
- 开展说话人切换的处理工作,从而避免出现抢话的情况。
随后,扩散模型作为“声音演员”,会依据LLM的“剧本指导”,来生成最终的音频。
这样的分工,让VibeVoice不仅可以生成语音,还能够去演绎对话,这也就是它最厉害的地方。
光说不练假把式。我花了一晚上的时间,把VibeVoice部署到了我的RTX 3090之上,它的显存为24GB,完全够用了。
# 克隆项目
git clone https://github.com/microsoft/VibeVoice.git

# 安装依赖
cd VibeVoice
pip install -r requirements.txt

# 下载模型(约5GB)
python download_model.py --model vibevoice-1.5b

# 启动服务
python server.py --port 7860
整个过程大概20分钟,比我想象的顺利多了。微软这次是真的考虑到了开发者的体验,文档写得清清楚楚,连Docker镜像都准备好了。
我试着生成了一个时长为90分钟的科技播客,它采用的是两个主持人进行对话的形式。
一段15,000字的对话脚本,可以被转换为90分钟的音频文件。
耗时大约为12分钟,所用设备为RTX 3090。显存占用的峰值达到了18GB。音质方面,MOS评分约为4.2/5.0,也就是主观听感的评分。
说实话,第一次听到输出结果的时候,我有点愣住了——两个主持人的对话,真的就像真人在聊天一样。不是那种“你一句我一句”的机械感,而是有互动、有停顿,甚至还有“嗯…让我想想”这类带有思考意味的语气词。
我又测试了一下实时流式输出,输入一段文字,看看第一个音节多久会出来。
结果大概是300毫秒左右。
这个速度,已经可以运用到实时语音助手当中了。虽然比不上ElevenLabs的商业API(约100ms),但鉴于这是开源模型,能在本地跑出这个速度,已经很惊艳了。
经过梳理后发现,VibeVoice的应用场景,远比我预想的要广泛。
要是你是播客创作者的话,VibeVoice简直就是生产力工具。
传统方式:先写脚本,再找主持人,接着进行录音,之后开展剪辑,最后完成后期。VibeVoice:写脚本,就可以一键生成。
相关的成本从几千块降到了几块钱,同时电费方面的开销也得到了控制,时间则从几天缩短到了几小时。
传统的TTS模型,要是生成一章大概1小时的音频就会显得很吃力。而VibeVoice则可以一口气生成整本书,前提是你的显存足够大。
我们可以试想一下,在英语教学软件当中,不再是那种单调的“跟读”模式,而是呈现出真实的对话场景。比如老师和学生、医生和病人、店员和顾客这类场景,VibeVoice可以生成具备四个角色的对话内容,让英语学习更具有代入感。
游戏里的NPC,不再需要去预录几千句台词。VibeVoice可以借助玩家的选择,实时生成NPC的回应——并且语气、情绪都能根据上下文来进行调整。
为了能够更加客观地对VibeVoice进行评价,我找了几个主流的TTS模型来开展对比工作:
| 模型 | 长音频支持 | 多角色对话 | 实时性 | 开源 |
|---|---|---|---|---|
| VibeVoice | ✅ 90分钟 | ✅ 4人 | ✅ 300ms | ✅ |
| Coqui TTS | ❌ 最多10分钟 | ❌ 单人 | ⚠️ 1-2秒 | ✅ |
| XTTS v2 | ⚠️ 最多30分钟 | ⚠️ 2人 | ⚠️ 800ms | ✅ |
| ElevenLabs | ✅ 无限制 | ✅ 多人 | ✅ 100ms | ❌ |
从表格当中能够看出,VibeVoice在开源模型当中,几乎是无敌的存在。唯一的短板是其实时性略逊于商业API,但考虑到它是开源的、可以在本地进行部署,这个差距完全可以接受。
当然,VibeVoice也并非完美的。用了几天之后,我也发现了一些问题。
虽然官方表示4GB显存就可以跑0.5B模型,但实际测试下来,要是想要生成高质量的90分钟音频,至少需要16GB显存。RTX 3060也就是12GB的版本勉强可以运行,但运行起来会很吃力。
当前所支持的语种主要涵盖英语、中文以及日语。至于其他语种,虽说已经具备了基础层面的支持,不过其实际效果显然要比主流语种逊色不少。
虽然VibeVoice可以根据上下文来调整语气,但在极端情绪也就是愤怒、哭泣的表达上,还是带有一点“AI味”的。能够听出来这是合成语音,并非真人的录音。
要是需要毫秒级响应,比如实时语音通话这类场景,VibeVoice还是会显得有点慢。这种情况,还是得选用专门的低延迟TTS引擎。
经过对VibeVoice的研究,可以得出这样的结论:要是你属于内容创作者、教育工作者,或是游戏开发者,那么这个工具值得去尝试一下。
适合用的场景:
- 播客制作(尤其是多主持人对话)
- 有声书、音频课程
- 教育软件的情景对话
- 游戏NPC的动态语音
- 企业培训、知识库的音频化
不适合的场景:
- 实时语音通话(延迟要求太高)
- 超精细音效合成(比如ASMR)
- 小语种深度应用
说实话,微软这次把VibeVoice开源出来,还是让我有点意外的。
要知道,语音合成毕竟是微软Azure的重要业务之一。要是把这么强的技术直接开源出来,那不就相当于砸自己的饭碗吗?
但仔细琢磨一下,微软的格局确实有所不同。开源VibeVoice,相当于把语音AI的门槛,从“大公司专属”降到了“个人开发者也能参与”。
这对于整个生态来说都是好事。更多的开发者可以借助VibeVoice来开展创新工作,更多的应用场景会被挖掘出来,最终推动整个语音AI领域向前进一步发展。
这才是开源的真正意义所在——不是简单的“代码共享”,而是“降低创新的门槛”。
要是你对VibeVoice感兴趣的话,我的建议是:不要只看相关文章,动手去尝试看看。
GitHub地址:https://github.com/microsoft/VibeVoice
部署其实并不复杂,只要你拥有一张NVIDIA显卡,也就是RTX 3060以上的型号,按照文档一步步进行操作,半小时之内就可以将其运行起来。
你可以试着生成一段时长为5分钟的对话音频,这样就能对AI语音合成拥有全新的认识。




暂无评论内容